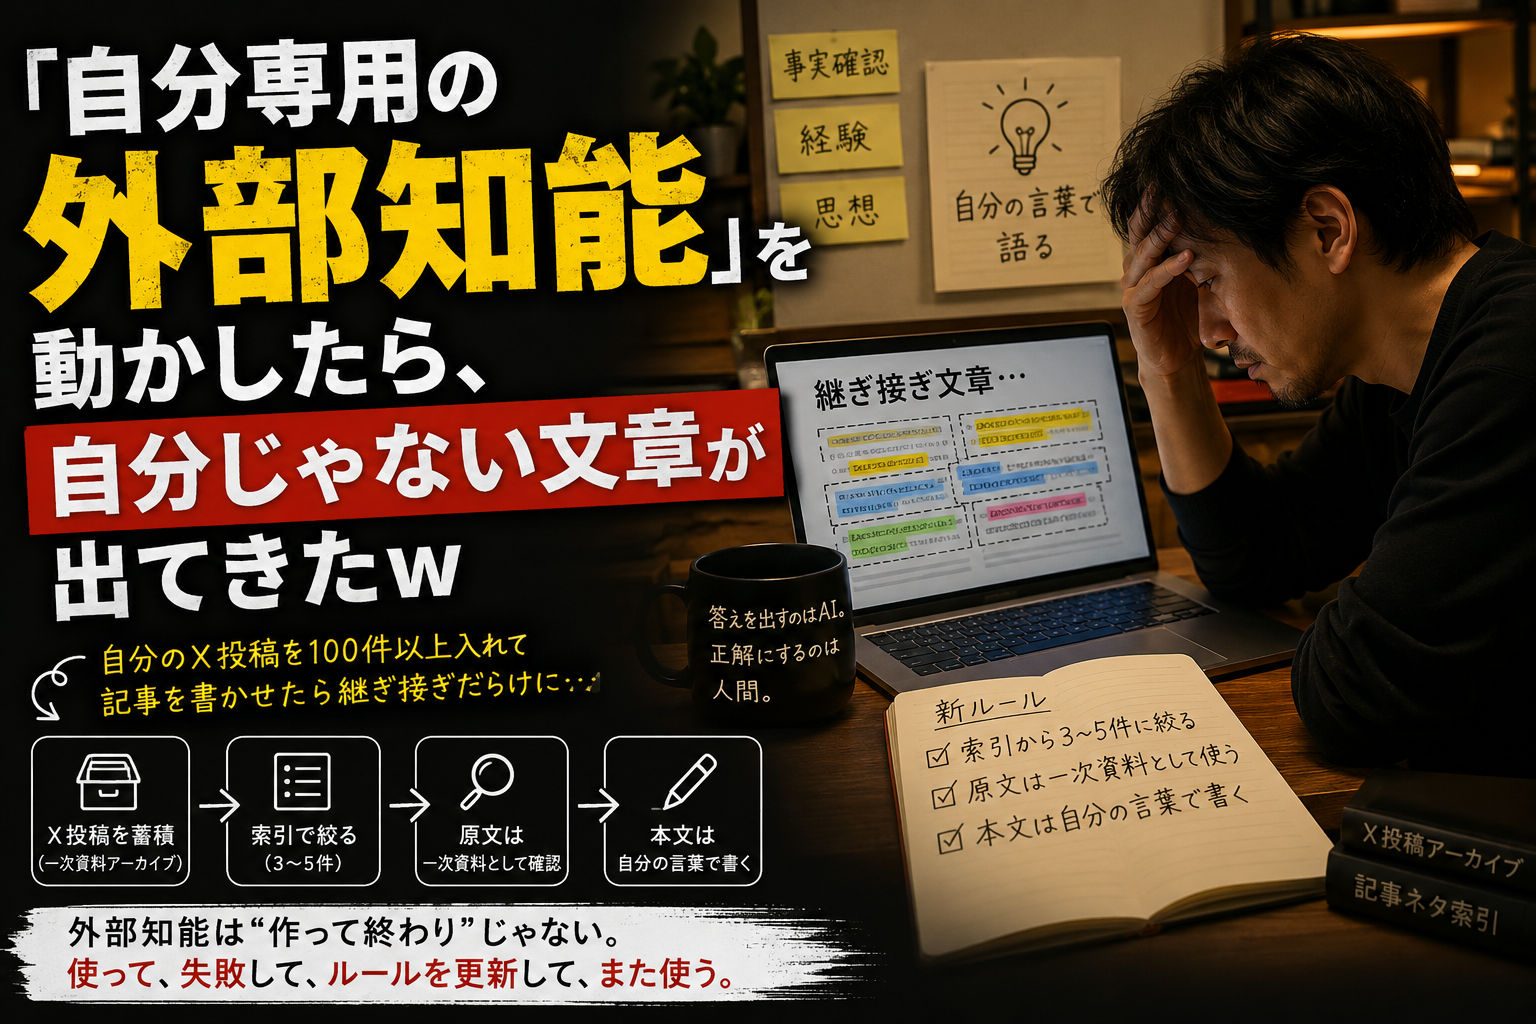
少し前に、自分のXを3万件以上掘り返して、「自分専用の外部知能」を作り始めたという記事を書きました。
自分が昔書いた文章。
仕事で考えていたこと。
判断基準。
失敗。
「これ、今読んでも自分っぽいな」と思う投稿。
そういうものをObsidianに集めておけば、AIに自分のことを毎回ゼロから説明しなくて済む。
これはかなり使えるんじゃないか。
そう思って、今も少しずつ育てています。
で、今日。
警備会社で働いていた頃のX投稿を100件以上まとめて、いよいよ本格的に記事制作へ投入してみました。
結果。
なんか、喋ってるのがぼくじゃない。
いや誰やねんこれw
昔のXを100件以上、外部知能に追加した
やったこと自体は、かなりいいと思っています。
警備会社時代のX投稿を掘り起こして、Googleドキュメントにまとめました。
そこには、
- 現場で起きた出来事
- 採用や面接の失敗
- 人手不足
- 管制の愚痴
- 仕事観
- 人を見るときの判断基準
- 当時のぼくが強く思っていたこと
なんかが大量に残っていました。
昔の自分、めちゃくちゃ喋っとるw
これをClaude Codeに読ませて、Obsidianへ2種類のファイルを作りました。
一つは、投稿をなるべく原文のまま残した一次資料アーカイブ。
もう一つは、
「採用」
「管制」
「人手不足」
「できる警備員」
「仕事観・処世術」
みたいに分類した記事ネタ索引。
ここまではかなり良かったんです。
「おお、外部知能っぽくなってきたぞ!」
と。
問題は、そのあとでした。
過去の自分を読ませたら、自分らしくなると思っていた
その資料を使って、警備会社時代の採用について記事を書かせました。
テーマは、
「何百人も面接して分かった。『この人ヤバいな』を無視すると、だいたい後悔する」
というもの。
元になるX投稿もある。
当時の考えも残っている。
具体的なエピソードもある。
つまり、
自分の材料しか入っていない。
なら、かなり自分らしい記事が出てくると思うじゃないですか。
ところが実際に読んでみると、
「あれ?」
となった。
過去のX投稿の言い回し。
AIが作った説明。
別のX投稿。
またAIのつなぎ文。
それらが順番に並んでいる。
一応、言っていることはぼくなんです。
事実もだいたい合っている。
でも文章全体を読むと、
「昔のぼくのツイートを素材にして作ったコラージュ」
みたいになっていた。
自分の文章を大量に入れたのに、むしろ自分が薄まった。
いや、どういうことやねんw
「本人の文章を使う」と「本人が喋っている」は別だった
ここで一つ気づきました。
ぼくは、
本人の文章をたくさん参照すれば、本人らしい文章になる
と、なんとなく思っていたんです。
でも違いました。
本人が過去に書いた文章を並べることと、
本人が今、過去を振り返って一から喋ること
は別です。
Xの投稿なんて、その瞬間の感情や出来事を数行で切り取ったものです。
それを大量に記事へ持ち込めば、当然それぞれの断片が強くなる。
「このとき、こう書いていた」
という一次資料としては最高です。
でも、そのまま文章の部品として使い始めると、
記事全体の声がバラバラになる。
過去の自分を保存しておくことと、
過去の自分をそのまま貼り合わせることは違う。
ここ、実際に使うまであまり考えてませんでした。
外部知能には全部入れる。でも、AIには全部渡さない
そこで運用を変えました。
まず、過去のX投稿そのものは、これまで通り外部知能に残しておく。
100件でも1000件でもいい。
保存しておけば、あとから探せます。
でも記事を書くときは、いきなり大量の原文を使わせない。
まず記事ネタ索引だけを見る。
そこで、
「今回の記事に必要なのは、この3件とこの2件だな」
と絞る。
そのあとで、該当する原文だけ確認する。
つまり、
外部知能にはたくさん持たせる。
仕事をするときは、必要なものだけ取り出す。
この形に変えました。
考えてみれば当たり前なんですよね。
資料室に本が1万冊あるからといって、
会議の机に1万冊全部積み上げる必要はない。
むしろ邪魔ですw
必要な本を数冊持ってくればいい。
Obsidianも同じでした。
X投稿は「文章の材料」ではなく「一次資料」にした
もう一つルールを変えました。
過去のX投稿は、
記事本文を作るための文章パーツ
として使わない。
代わりに、
「本当にそんなことがあったか」
「当時どう考えていたか」
「具体的に何と言っていたか」
を確認する一次資料として使う。
記事本文は、今のぼくがその出来事を振り返って、一から話す。
強い言葉があれば引用する。
でも基本は引用の寄せ集めにしない。
この違いだけで、だいぶ扱いやすくなりました。
外部知能って、
「昔の自分をそのまま呼び出す装置」
ではないんですよね。
むしろ、
昔の自分に確認を取りに行ける資料庫
に近いのかもしれません。
「あの頃、ぼく何て言ってたっけ?」
「あの話、本当にこうだった?」
「似たような経験、他にもあった?」
そういうときに掘りに行く。
その上で、今の自分が考える。
失敗したルールも、またObsidianに戻した
今回ちょっと面白かったのは、ここです。
記事制作で失敗した。
↓
原因を考えた。
↓
「X投稿を全部文章素材として扱わない」
「まず索引で必要な投稿を絞る」
という新しい運用ルールを決めた。
↓
そのルールを、またObsidianの記事制作フローに書き足した。
つまり、次の記事からは同じ失敗をしにくくなる。
Obsidianそのものが勝手に学習したわけではありません。
でも、
失敗した人間がルールを更新して、そのルールをAIが次回また使える場所へ残した。
これって、ぼくがやりたかった「外部知能を育てる」にかなり近い気がします。
毎回失敗して、
「前も同じことやった気がするな……」
で終わるんじゃない。
一回の失敗を、
次から使える判断基準に変える。
そうすれば少しずつ、毎回ゼロから考えなくてよくなる。
情報を増やすことより、必要な情報を選ぶ方が大事かもしれない
今回の一件だけで、
「AIには大量の情報を渡すな!」
なんて言うつもりはありません。
大量の資料を扱えるAIもありますし、仕事によって必要な情報量も全然違います。
ただ少なくとも、ぼくが自分の記事を作った今回のケースでは、
情報を増やせば増やすほど、自分らしい記事になるわけではなかった。
これはけっこう大きな気づきでした。
結局ここでも、人間の「検品」が必要でした。
AIに考えさせる。
出てきたものを読む。
「あれ? なんか違うぞ」
と気づく。
じゃあ何が違うのかを考える。
情報の渡し方を変える。
もう一回やる。
以前からぼくは、
「AIは答えを出すけど、その答えを正解にするのは人間」
と思っています。
今回の外部知能づくりも、まったく同じでした。
外部知能に情報を入れる。
AIが使う。
人間が検品する。
違和感があれば、使い方を変える。
そして、うまくいった方法をまた外部知能へ戻す。
たぶん「自分専用の外部知能を育てる」って、
データを大量に突っ込んで終わりじゃないんです。
使って、失敗して、ルールを直して、また使う。
そっちの方が大事なんだと思います。
まだ作り始めたばっかりなので、たぶんまた何かやらかしますw
でも、そのたびに一個ずつ外に残していけばいい。
そうやって少しずつ、
昨日の自分より、ちょっとだけ使える自分専用の外部知能
になっていけば十分なんじゃないでしょうか。
コメント